

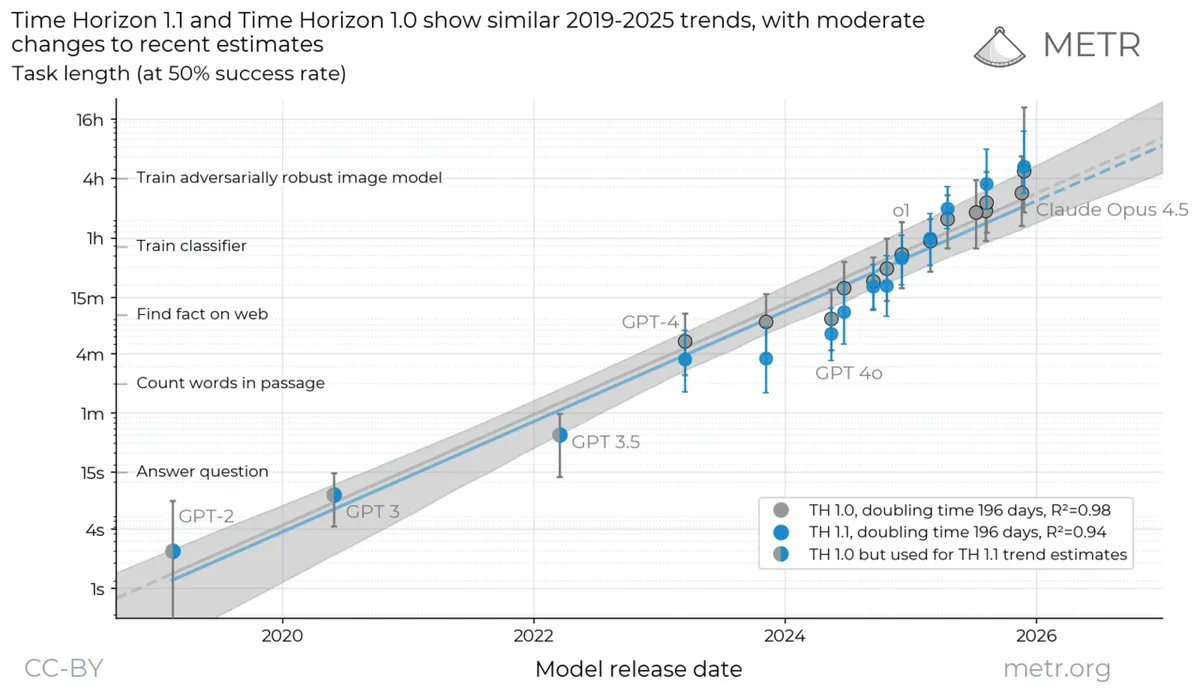
A organização METR divulgou uma atualização de seu gráfico que mede a capacidade de sistemas de IA. O gráfico compara tarefas que a IA consegue concluir com o tempo que pessoas levariam para fazê-las.
O novo relatório inclui tarefas mais abertas e que exigem julgamento. Nelas, os modelos ficaram abaixo do desempenho humano. Por exemplo, nenhum dos projetos de avaliação criados pela IA foi considerado útil pelos pesquisadores da METR.
O estudo ajuda a separar o que a IA já faz bem do que ainda faz mal. Isso importa para quem tenta prever o impacto da IA no trabalho científico e no desenvolvimento de novas IAs.
Os próprios especialistas dizem que ainda há pouca resposta definitiva. Os dados sobre tarefas abertas são difíceis de medir e de comparar.
Para a maioria das pessoas, nada muda agora. O relatório mede modelos e não traz nenhum novo produto ou risco para o uso do dia a dia.
Para quem trabalha com IA ou pesquisa o tema, vale a leitura. Ele mostra que tarefas de código avançam rápido, mas tarefas de julgamento ainda ficam para trás.
O que você pode fazer
Não há nada a fazer pelo usuário comum neste caso. Vale acompanhar as próximas atualizações da METR se o tema for do seu interesse profissional.
Como o assunto é de avaliação de modelos, não há orientação prática específica para o público geral.
Comentários